AI 影片製作全流程解構:由一句旁白到可交付的宣傳短片
CoLenS Studio 為 HKtag Smart Campus 2026 製作了活動宣傳片。這次製作結合生成式 AI 影片技術與專業後期製作,在更短的製作週期內做出高質素的視覺效果:以 AI 生成畫面與視覺元素,再配合專業剪輯與調色,令影片風格更具未來感,貼合「智慧校園」的主題。
影片以簡潔有力的敘事,向學校及教育界呈現 Smart Campus 2026 的核心理念與亮點,適合於社交平台及活動現場播放。
這篇文章想做的,是把這條生產線由頭到尾講清楚——由一段文字稿,到一條可以交付的成片。這個項目也展示了 CoLenS Studio 在 AI 影片製作上的定位:用 AI 提速創作流程,同時保持專業製作水準。
成片示範:HKtag Smart Campus 2026 宣傳片
下文所有步驟,指向的都是這條片。如影片未能顯示,可按此直接觀看,或瀏覽 CoLenS Studio 作品集。
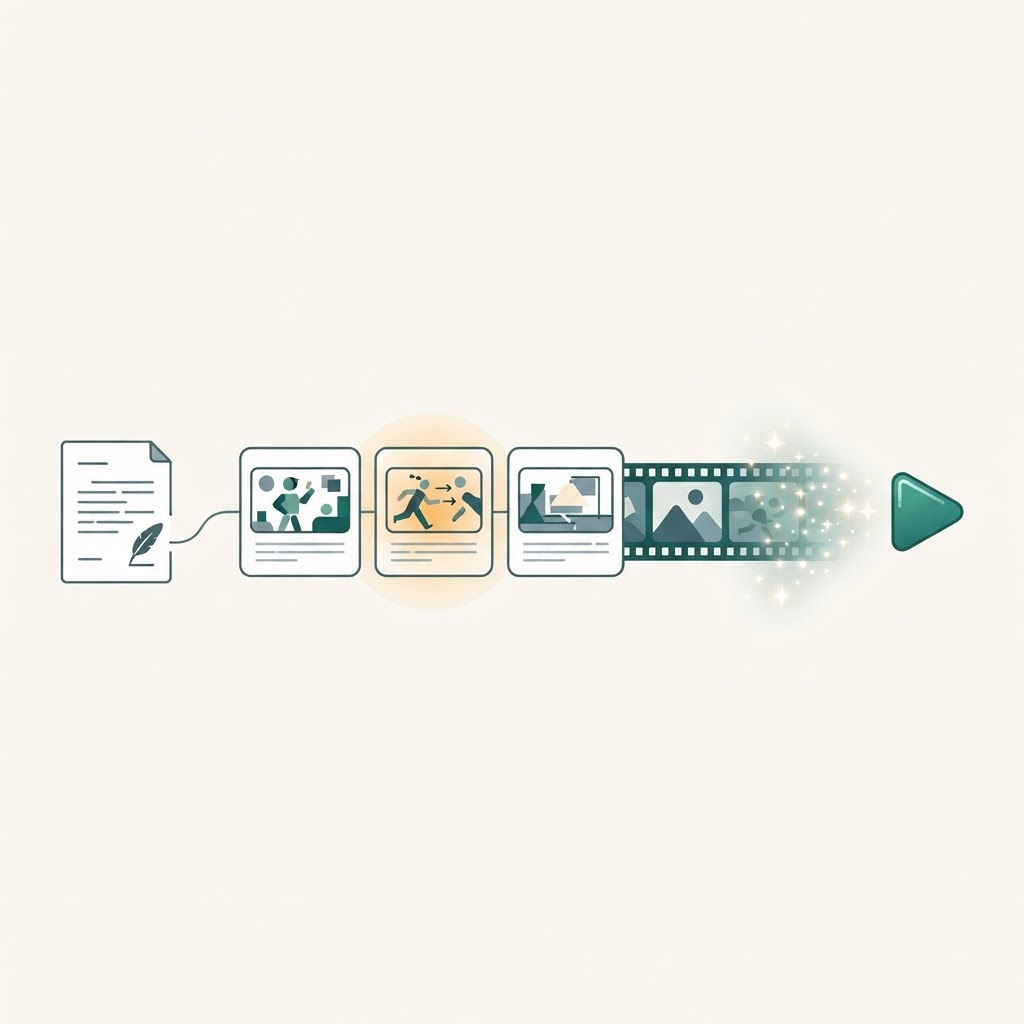
整條生產線的形狀:由文字稿出發,經分鏡驗證,才進入影片生成。
我們也決定把這套流程整理成教材。2026/27 年度的 AI 媒體製作工作坊,教的就是這條流程本身,而不是「今個月哪個工具最紅」。
先說明一件事:本文講的是方法與判斷。具體使用的模型、工具鏈、Prompt 範本、生成成本結構及內部管理系統,屬 Coxana 內部資產,不在此公開。
核心原則:先便宜地驗證,再昂貴地生成
AI 影片製作最容易犯的錯,是一開始就衝去生成影片。
影片生成是整條流程裡最貴、最不穩定的一環。同一個畫面重複生成十幾次仍未達標,是常態。所以真正的功夫在於:把構圖、角色、視覺方向、敘事節奏等問題,全部在還未開始生成影片之前解決。
一句話總結我們的做法:先知道自己想要甚麼 → 用低成本方式驗證 → 客戶確認 → 才批量生成 → 由人挑選 → QC 交付。
第一步:鎖定內容,而不是鎖定畫面
流程由旁白稿(Voice Over)確認開始,不是由「想像畫面」開始。
旁白稿確認時,我們會逐項核對活動名稱、人名、職銜、日期、地點、機構名稱,以及行動呼籲(報名連結、網站、QR Code)。這些是最容易出錯、也最不能出錯的資訊。
這裡有一條重要的規則:旁白稿確認之後的改動,成本是不對稱的。改幾個字、不影響語義與時間長度,可以直接吸收;但如果整段旁白、語言或敘事邏輯改動,相關的分鏡與畫面就必須重新評估。學生最需要理解的就是這點——內容改動在前期幾乎免費,在後期非常昂貴。
第二步:真人配音,不是 AI 配音
我們的正式旁白使用真人錄音。
原因不只是質感。真人錄音帶來的語氣、停頓與重音,是整條片的節奏骨架——後面所有畫面長度、剪接點與嘴形同步,全部對齊這條音軌。
實務上有兩個習慣:客戶提供的原始錄音永遠保留、不覆蓋;所有正式旁白會統一經過語音增強處理,讓不同來源、不同環境錄的聲音在音質上對得上。之後的分鏡動態稿、剪接與嘴形同步,全部使用增強後的版本,避免中途換音軌導致時間軸整條偏移。
第三步:由旁白拆解畫面
有了確認的旁白,下一步是逐句分析它的資訊重點,然後決定每一句應該用甚麼畫面來承載:
真人實拍、AI 生成場景、B-roll、動態圖像、字體排版、介面示範,還是數據視覺化。
同時要標記兩件事:哪些鏡頭需要人物說話(這些之後要做嘴形同步),哪些只需要旁白配畫面。這個分野會直接影響後期工序與成本。
整理出來的結果,是一張逐句對應的表:旁白句子、畫面類型、鏡頭編號、出現人物、是否需要圖像元素、預計秒數。先有這張表,才開始畫面製作。
第四步:角色一致性——先做「角色設定集」
AI 生成最常見的災難,是同一個人在不同鏡頭裡變成不同的人。
解決方法不是事後補救,而是先為每位出鏡人物建立一套完整的角色參考:正面、左右四分之三側面、正側面、全身、中景、近景,加上自然表情與說話表情。等於一套三視圖,再加遠、中、近景與頭像。
同時用文字記錄可辨識特徵:髮型、服裝、面型、是否戴眼鏡、年齡感、身材比例。
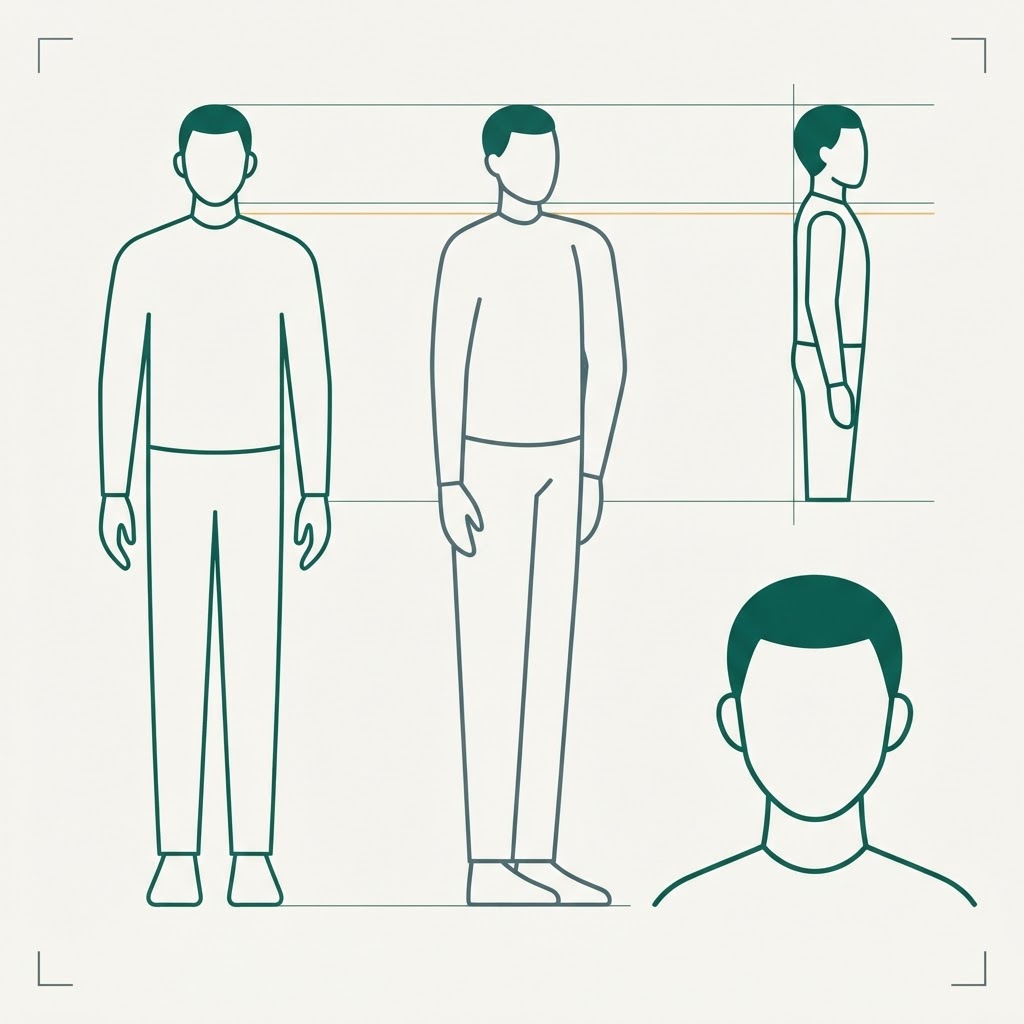
角色設定集的概念:同一個人物,多角度、多景別先固定下來。
然後逐項檢查:近景像不像本人?全身照仍然像不像本人?側面的身份是否穩定?多人同場時各人身份是否清楚?身高比例是否合理?服裝是否一致?
客戶提供的人物照片越完整,角色一致性通常越高。這是前期資料收集值得花時間的地方。
第五步:分鏡圖像——低成本的探索階段
接著生成分鏡靜態圖像。這一階段的定位很清楚:這是探索期,成本低,所以要在這裡把問題解決完。
做法是逐個場景生成、逐個場景檢視,確保角色與美術方向一致。需要對齊的項目包括畫面比例、色調、光線、鏡頭語言、人物外觀、服裝、場景設計與整體美術方向。
所有分鏡圖像在進入影片生成前,都必須由人親手篩選一次。AI 生成的東西不會自己變好,篩選是人的責任。
第六步:動態分鏡稿——最關鍵的一關
這是整條流程最重要、也最常被跳過的一步。
我們會用已篩選的分鏡靜態圖 + 真人增強旁白 + 暫定音樂,按預計時間排列成一條「動態分鏡稿」。需要的位置放上簡單的圖像佔位。
這個階段不生成任何正式 AI 影片。
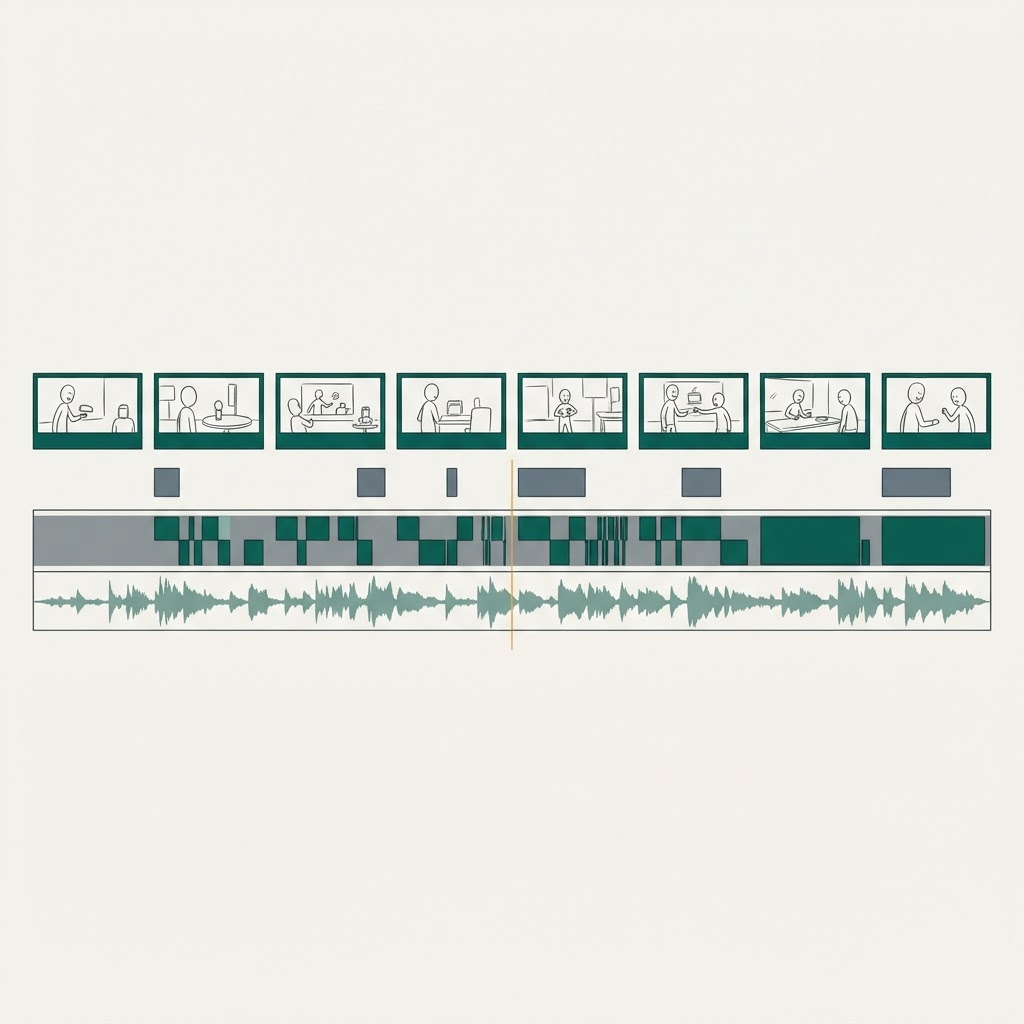
動態分鏡稿:靜態圖 + 真人旁白 + 暫定音樂,足以看出敘事與節奏問題。
然後交客戶檢視:故事流程、鏡頭順序、人物相似度、視覺方向、節奏快慢、旁白、音樂方向、需要哪些圖像元素。
客戶確認之後,視為創作方向鎖定,才進入正式影片生成。
為甚麼這一關這麼重要?因為靜態圖排出來的一條片,已經足夠看出敘事有沒有問題、節奏是否拖沓、人物像不像。這些問題在這裡改,幾乎不用成本;在生成影片之後改,等於整段重做。
第七步:由圖到片
創作方向鎖定後,才開始影片生成。我們採用圖生片的方式——以已確認的分鏡圖作為畫面基礎,而不是純文字生成。這樣構圖、角色與美術方向都已經固定,變數大幅減少。
實務參數上,單一鏡頭長度通常在八秒上下,畫面比例 16:9。
一個實戰經驗值得寫給學生:生成模型會自己加鏡頭切換。你想要一個連續長鏡頭,它給你切三次。所以指令必須明確要求維持單一連續鏡頭、不要切換場景、維持相同構圖與人物、不要改變機位。
另一個習慣是先試一個代表性鏡頭,再開始批量。我們會從已確認的分鏡中挑一個最具代表性或風險最高的場景,先做正式生成測試,確認人物匹配度、動態、鏡頭運動與文字清晰度都達標,才把整批鏡頭排隊生成。用一個鏡頭的成本,換整批鏡頭的確定性。
第八步:生成之後,仍然要人來選
生成可以大量自動化,選擇不可以。
每一條生成結果都要人檢視四個範疇:
人物——臉、身份、手部、身體比例、服裝有沒有走樣。手部尤其常見問題。
動態——動作自然度、有沒有無故加速或變慢、有沒有掉幀、鏡頭運動是否合理。
背景——建築有沒有融化、Logo 有沒有變形、人群有沒有互相溶解、物件有沒有無故消失。
文字——繁體字是否準確、有沒有變成簡體、字形有沒有錯、Logo 有沒有畫錯。這是繁體中文市場的特別痛點。
出問題時的處理方向是有規律的:人物走樣先調角色參考;鏡頭錯先加機位限制;動態不自然先簡化動作;背景出錯先調場景或來源圖;切鏡太多就強調長鏡頭;文字出錯就直接改用圖像元素,不要跟模型鬥氣。
版本管理上有一條紀律:重新生成不要覆蓋舊檔。已選定的版本保持不變,直到出現明顯更好的結果,才由人手動取代。
第九步:嘉賓的嘴形同步
這是很多人最好奇的一環:讓 AI 生成的人物「說出」真人錄音的內容。
順序很重要——先把整條片剪好,再做嘴形同步,不是反過來。
做法是:先在剪接時鎖定需要說話鏡頭的起訖時間點;把該段單獨輸出;用真人錄音驅動嘴形同步;完成後把成品替換回原本鏡頭;最後檢查時間、幀、色調、動態與聲畫同步。
畫面條件直接決定成敗,幾乎沒有例外:嘴部要清楚可見、不能被遮擋、不能太側面、不能太遠、頭部動作不能太激烈。這些條件在分鏡階段就要設計好——如果一個說話鏡頭拍成大遠景側面,後期是救不回來的。
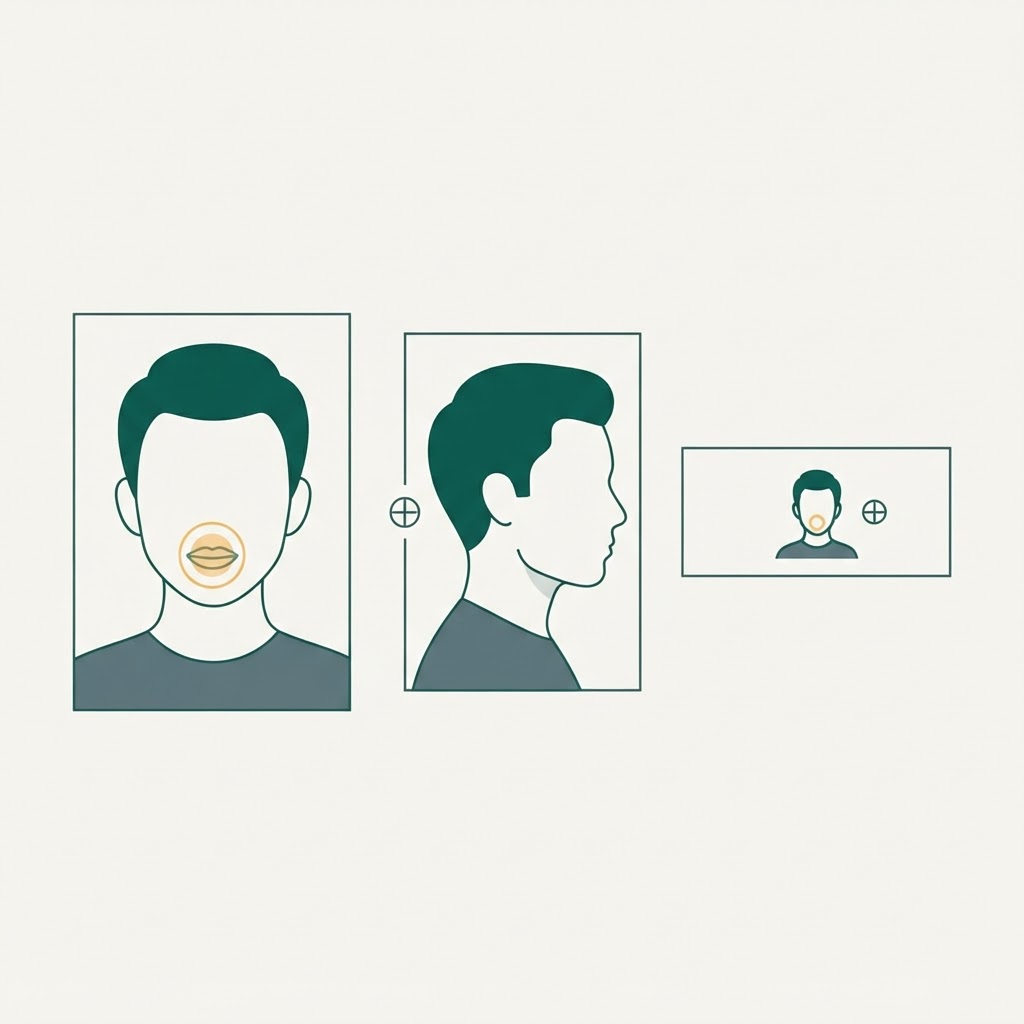
可用與不可用的說話鏡頭構圖。這是分鏡階段的決定,不是後期的決定。
第十步:重要資訊不交給 AI
這是我們的明確立場:準確度優先於「全 AI」純度。
凡是不能錯的資訊,一律用圖像元素製作,不強求 AI 生成:QR Code、網址、電話、日期、Logo 與贊助商標誌、講者姓名與職銜、活動名稱與行動呼籲。
其中 QR Code 有一條硬規則:絕對不可以用 AI 生成,也不可以經生成式 AI 改寫。QR Code 的像素圖案本身就是資料,改動一個模塊就掃不到。必須使用原始檔案疊加。成片輸出後還要用實機掃描確認能開啟正確連結,並讓畫面停留約四秒以上,給觀眾足夠時間掃。
環境性文字(例如街景招牌)可以交給 AI,畫面正確可讀就足夠。功能性文字不可以。
第十一步:字幕與聲音
字幕在整條片剪接及旁白完成之後才生成,避免時間軸變動導致重做。生成後必須人工校對——特別是人名、公司名、活動名稱、英文專有名詞與數字。工具在這幾類上出錯率最高。
聲音方面的優先次序很簡單:旁白第一優先,背景音樂永遠不可以蓋過旁白,按需要加入音效與環境聲,最終整體聽感要一致。
第十二步:三次觀看法 QC
交付前的品質檢查,我們用三種不同的觀看方式,因為每一種會抓到不同的問題:
靜音觀看——只看畫面。專門抓視覺連續性、圖像元素、錯別字、Logo、QR Code 與 AI 破綻。關掉聲音,眼睛會誠實很多。
只聽聲音——不看畫面。專門抓旁白、音樂、音量平衡、剪接點與聲畫同步。
完整觀看——當一個普通觀眾。看故事是否成立、節奏是否舒服、情緒是否流暢、行動呼籲是否清楚。
最後逐項核對:旁白與客戶確認版本一致、人名職銜活動名日期地點正確、人物身份一致沒有明顯走樣、鏡頭動態自然、繁體字正確、QR Code 實機可掃、行動呼籲與網址正確、嘴形同步正常、字幕專有名詞正確、音樂不蓋旁白。
成片交付規格為 1920 × 1080、16:9、H.264、30fps、Rec.709。
2026/27 AI 媒體製作工作坊會教甚麼
把上面整條流程收起來,其實只有三個能力值得教:
一、先想清楚,再動手。學生會由旁白稿開始,逐句拆解資訊重點,決定畫面策略,畫出鏡頭表。這一步不用任何生成工具。
二、用最低成本驗證創作方向。學生會做出自己的動態分鏡稿——靜態圖加旁白加音樂——並在同學面前放映一次。多數問題會在這裡被發現,而不是在成片。
三、生成之後的判斷力。學生會拿到多個生成版本,練習用四個範疇(人物、動態、背景、文字)逐項檢視,說明自己為甚麼選這一個。這是整個工作坊最核心的訓練:AI 負責生成與加速,人負責方向、選擇與最終判斷。
我們不打算教「哪個工具最好用」。工具三個月就換一次,判斷力不會。
一句話總結
這套流程的重點從來不是「識用某一個模型」,而是:知道自己想要甚麼 → 用低成本方式驗證 → 確認鎖定 → 批量執行 → 由人挑選最好的結果 → 品質檢查 → 交付。
AI 是執行力的放大器,不是創作判斷的替代品。操作者必須先知道自己想要甚麼,才把執行交給工具。
想把這條流程帶進課堂?可參閱 AI 媒體製作工作坊的課程詳情,或瀏覽 CoLenS Studio 作品集了解更多製作案例。